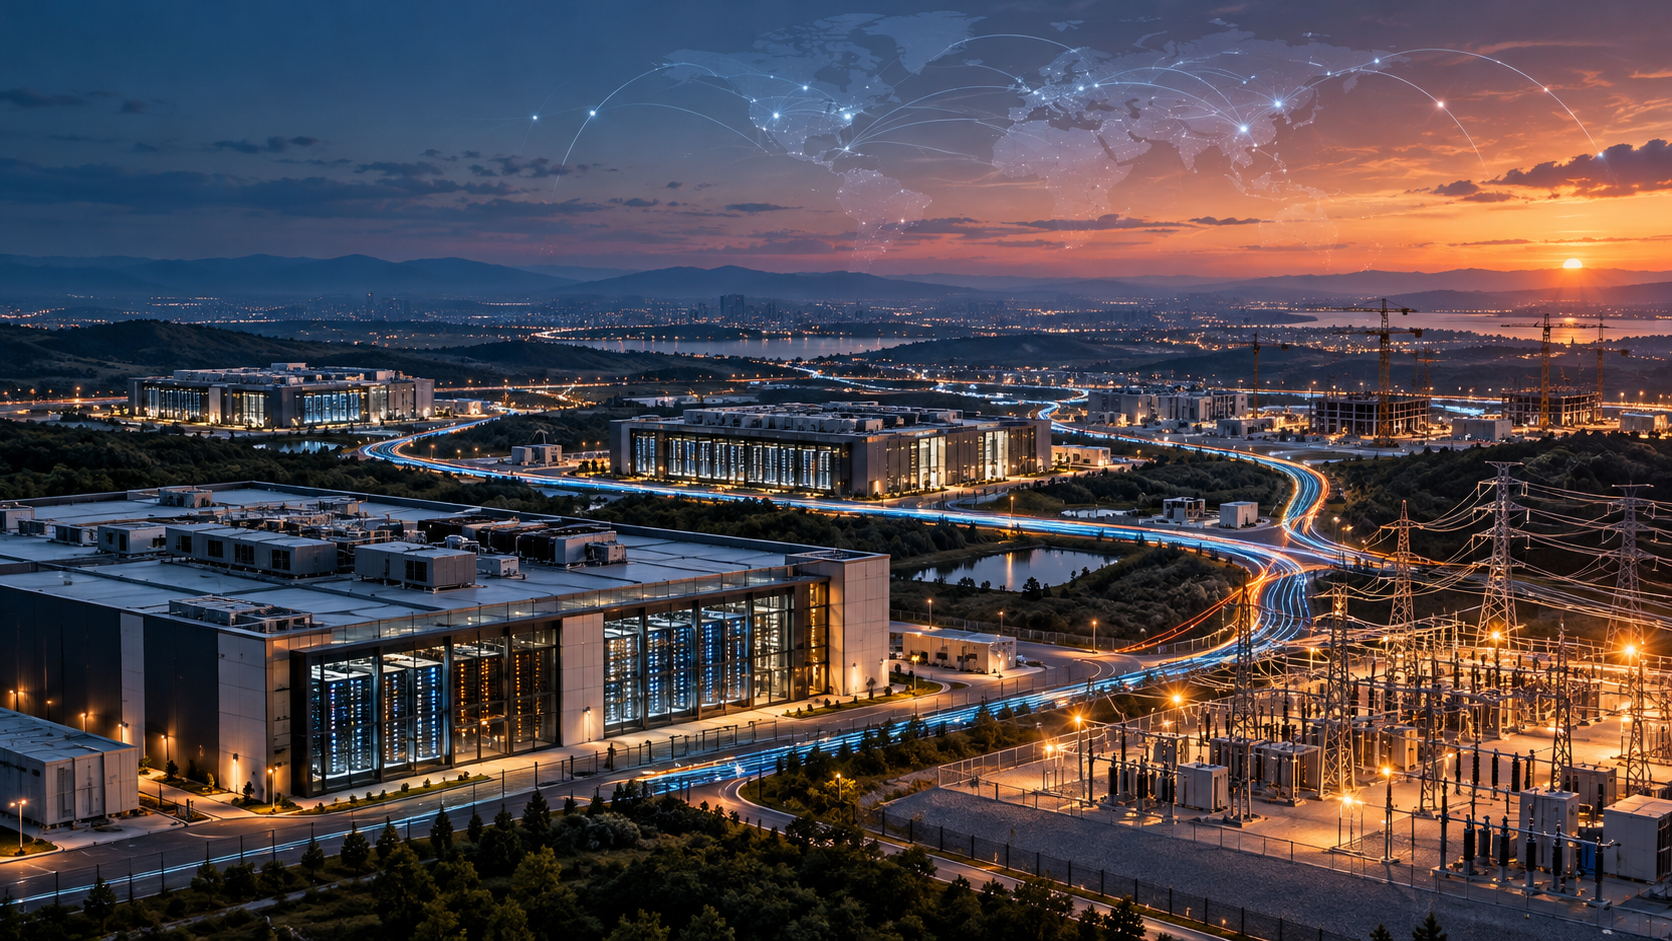
La inteligencia artificial ya no compite solamente por mejores modelos. También compite por infraestructura de IA: energía, terrenos, centros de datos, aceleradores, redes y capacidad de nube. Quien asegure esos recursos puede entrenar antes, atender más usuarios y reducir su dependencia de terceros.
Esta carrera involucra compañías con modelos distintos. Un hyperscaler puede repartir riesgos entre regiones y productos; una neocloud puede moverse con rapidez, pero depender de pocos clientes; un fabricante de chips puede influir en toda la arquitectura sin operar cada edificio.
Quién está invirtiendo
Amazon, Microsoft, Alphabet y Meta encabezan la expansión por su acceso a capital, demanda propia y plataformas globales. Microsoft proyectó alrededor de US$190 mil millones de gasto de capital para 2026. Alphabet situó su expectativa entre US$180 mil millones y US$190 mil millones, principalmente para infraestructura técnica. Meta estimó entre US$130 mil millones y US$145 mil millones.
Estas cifras corporativas no equivalen íntegramente a centros de datos de IA: también pueden incluir servidores, redes, arrendamientos y otros activos. Amazon, por su parte, señaló que una parte sustancial de la capacidad de AWS financiada en 2026 ya tenía compromisos de clientes y sería monetizada principalmente en años posteriores.
Cuatro tipos de participantes
| Grupo | Ejemplos | Ventaja | Riesgo |
|---|---|---|---|
| Hyperscalers | AWS, Azure, Google Cloud | Escala, clientes y balance | Capex alto y complejidad |
| Neoclouds | CoreWeave, Nscale | Especialización y despliegue de GPU | Deuda y clientes concentrados |
| Fabricantes | NVIDIA, AMD | Chips, red y plataformas | Ciclos tecnológicos rápidos |
| Colocation | Operadores regionales y globales | Edificio, energía y refrigeración | Conexiones y ocupación |
CoreWeave ilustra el modelo neocloud: combina infraestructura especializada con contratos de capacidad. En octubre de 2026 anunció 240 MW en India y reportó aproximadamente 4.2 GW de potencia contratada. Potencia contratada no significa potencia ya energizada; esa diferencia es esencial para evaluar cualquier anuncio.
Las estrategias de AWS, Microsoft, Google y Meta
- AWS: combina GPU de terceros con sus chips Trainium, servicios de Bedrock y una red global. Busca controlar costo, suministro y software sin depender de una sola familia de aceleradores.
- Microsoft: integra Azure, modelos y aplicaciones como Copilot, mientras contrata centros externos y despliega GPU y aceleradores propios. Su escala permite mover cargas, pero no elimina el riesgo de cada ubicación.
- Google: conecta sus TPU, AI Hypercomputer, Google Cloud, Gemini y productos de consumo. Es un ejemplo claro de integración vertical.
- Meta: construye capacidad principalmente para sus recomendaciones, publicidad, Llama y Meta AI. También usa asociaciones financieras: en 2026 anunció con BlackRock una empresa conjunta para un campus en El Paso.
NVIDIA, AMD y los chips propios
NVIDIA ya no vende solamente GPU: sus plataformas integran CPU, aceleradores, NVLink, redes y diseños de centros de datos. Vera Rubin muestra el cambio hacia sistemas completos a escala de rack. Esa integración facilita rendimiento, pero también puede aumentar dependencia de un ecosistema.
AMD compite con Instinct, EPYC, Pensando y ROCm. Su plataforma Helios integra 72 GPU MI455X con CPU, red y software. Al mismo tiempo, AWS, Google, Microsoft y Meta desarrollan aceleradores propios para obtener una segunda fuente, ajustar el hardware a sus cargas y mejorar costos.
Por qué se reservan energía y terrenos con años de anticipación
Una GPU puede fabricarse más rápido que una subestación o línea de transmisión. Por eso las empresas aseguran terrenos cercanos a redes, agua, fibra y permisos antes de conocer toda la demanda futura. También firman contratos eléctricos, financian infraestructura o estudian generación dentro del sitio.
El objetivo no es únicamente conseguir megawatts, sino tenerlos en una fecha útil. Un terreno barato pierde valor si la conexión llega después de que el chip planeado haya sido reemplazado por otra generación.
Cómo se compra la capacidad
- Construcción propia: ofrece control, pero concentra inversión y ejecución.
- Arrendamiento: un operador entrega espacio y potencia durante varios años.
- Reserva de nube: el cliente compromete consumo para asegurar GPU.
- Compra de equipos: servidores y aceleradores se adquieren antes de que el edificio esté listo.
- Empresa conjunta: socios financieros comparten activos, deuda y riesgo.
Estos acuerdos se apoyan entre sí: un contrato con un cliente solvente facilita crédito; el crédito paga equipos y construcción; la instalación energizada genera ingresos. Si falla un eslabón, el calendario completo puede romperse.
Integración vertical: del chip a la aplicación
Integrar verticalmente significa controlar varias capas: silicio, servidores, centro de datos, nube, modelo y aplicación. La ventaja es optimizar el sistema completo y capturar más margen. El costo es invertir en múltiples tecnologías y correr el riesgo de que una decisión propietaria quede atrás.
La concentración también crea barreras de entrada. Un nuevo competidor necesita chips, energía, personal, capital y clientes simultáneamente. Además, el software suele estar optimizado para plataformas dominantes, lo que encarece cambiar de proveedor.
El caso Loughton: contrato sin electricidad
Microsoft terminó su contrato como cliente principal del centro de Nscale en Loughton, Inglaterra. El proyecto se anunció con 50 MW y posibilidad de crecer a 90 MW, inicialmente con 23,040 GPU NVIDIA GB300. Según Data Center Knowledge, la energía suficiente podría no llegar hasta principios o mediados de la década de 2030.
Nscale indicó que continúa comprometida con el sitio, busca fuentes alternativas y conserva otros contratos con Microsoft. El caso no demuestra que desapareció la demanda de IA; demuestra que capacidad anunciada, contratada y operativa son categorías diferentes.
Riesgos y oportunidades regionales
Los riesgos principales son sobrecapacidad, deuda costosa, obsolescencia de GPU, dependencia de pocos clientes, permisos y retrasos eléctricos. Para las empresas compradoras también existe riesgo de precio, disponibilidad y quedar atadas a un proveedor.
Las oportunidades regionales no exigen competir frontalmente con un hyperscaler. Un operador puede ofrecer energía realmente disponible, inferencia cercana al usuario, nube soberana, integración híbrida, refrigeración eficiente o servicios administrados. La credibilidad nace de demostrar capacidad energizada, no sólo un terreno y una presentación.
Qué observar antes de creer un anuncio
- Potencia contratada frente a potencia ya energizada.
- Fecha y condiciones de conexión eléctrica.
- Cliente ancla y duración real del contrato.
- Financiamiento comprometido y equipos comprados.
- Flexibilidad para reutilizar el sitio con otro cliente o chip.
La carrera por la infraestructura de IA no tendrá un único ganador. Probablemente producirá una red de hyperscalers, fabricantes, neoclouds y operadores regionales. La ventaja sostenible será convertir capital y contratos en capacidad confiable, utilizada y rentable.
Fuentes consultadas
- Microsoft: resultados del tercer trimestre fiscal de 2026.
- Alphabet: presentación para inversionistas de junio de 2026.
- Meta: resultados del segundo trimestre de 2026.
- Amazon: carta de 2025 a accionistas.
- Meta y BlackRock: proyecto de El Paso.
- CoreWeave: expansión en India.
- NVIDIA: plataforma Vera Rubin.
- AMD: Instinct y Helios.
- Data Center Knowledge: caso Loughton.
Descubre más de Anivia Mx
Suscríbete para recibir las últimas entradas en tu correo electrónico.