Cuando escribes una pregunta en una aplicación de inteligencia artificial, la respuesta parece nacer dentro de tu dispositivo. En realidad, el trabajo suele ocurrir en un edificio equipado para alimentar, conectar y enfriar miles de procesadores. Entender cómo funciona un centro de datos de IA permite dimensionar la infraestructura física detrás de un servicio aparentemente intangible.
¿Qué es un centro de datos de inteligencia artificial?
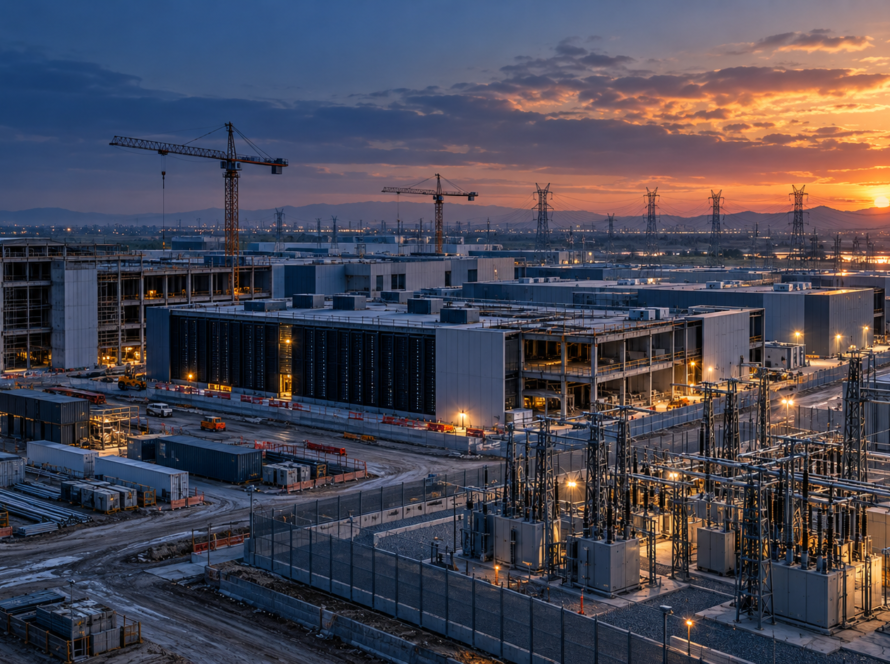
Es una instalación preparada para operar servidores, almacenamiento y redes de forma continua. También incluye distribución eléctrica, refrigeración, protección contra incendios, seguridad y monitoreo. Una sala de servidores tradicional puede ocupar una habitación; un centro de datos controla el ambiente y la conectividad a una escala mucho mayor.
Cuando se especializa en IA incorpora numerosos aceleradores —como GPU o TPU—, redes de baja latencia y almacenamiento capaz de entregar datos sin frenar el cálculo. No basta con comprar GPU: cómputo, red, energía, refrigeración y software deben funcionar como un sistema.
Tipos de centros de datos
| Modelo | Característica | Uso habitual |
|---|---|---|
| Empresarial | Una organización lo opera para sí | Control y sistemas internos |
| Colocation | El proveedor opera el edificio | El cliente instala sus equipos |
| Hyperscale | Infraestructura a enorme escala | Nube y servicios digitales |
| Especializado en IA | Alta densidad de aceleradores | Entrenamiento e inferencia |
Las categorías pueden mezclarse: un hyperscaler puede construir salas para IA y una empresa puede colocar su clúster dentro de un centro de colocation.
La arquitectura física
Racks, CPU y aceleradores
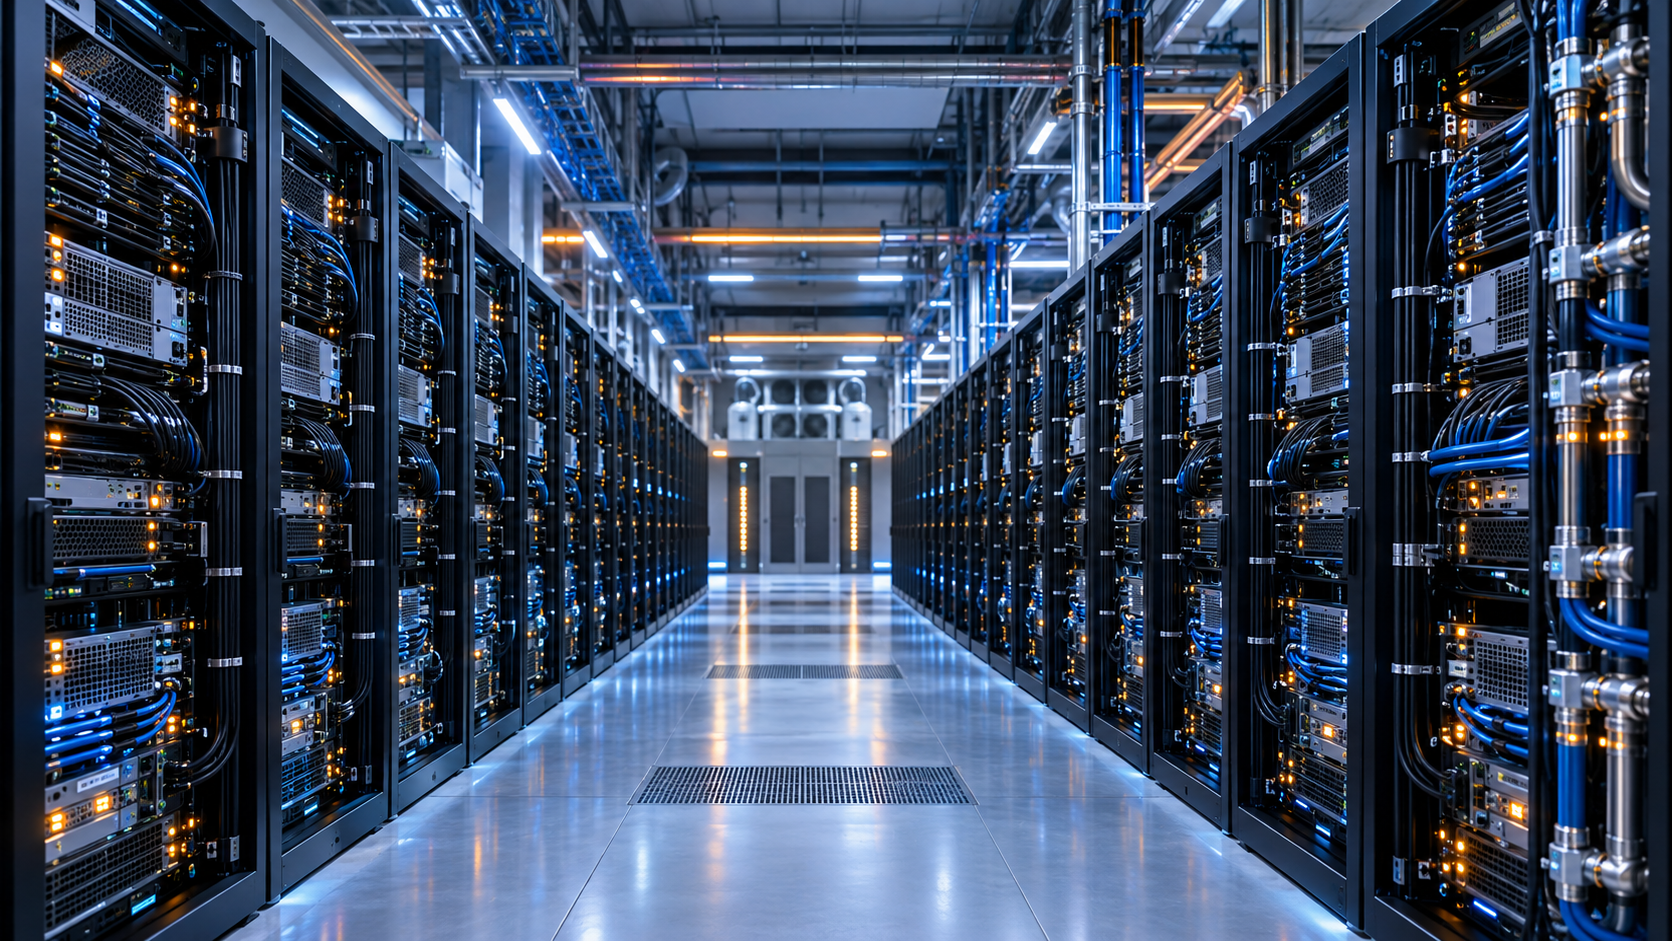
Los servidores se montan en gabinetes verticales llamados racks. Integran CPU, memoria, discos e interfaces de red. La CPU coordina tareas generales; la GPU ejecuta muchas operaciones matemáticas en paralelo. La guía de NVIDIA DGX H100/H200 ilustra un nodo moderno con bandejas de GPU, fuentes redundantes y conexiones de cómputo y almacenamiento.
Red y almacenamiento
En el entrenamiento distribuido, los aceleradores intercambian resultados constantemente. Una red lenta deja procesadores costosos esperando. La arquitectura de AI Hypercomputer separa el tráfico general del tráfico dedicado entre GPU. El almacenamiento conserva datos, parámetros y puntos de recuperación y debe entregarlos con suficiente velocidad.
Software
Controladores, bibliotecas de cálculo, contenedores y orquestadores asignan trabajos, vigilan fallas y sustituyen nodos. Google presenta AI Hypercomputer como una integración de aceleradores, red, almacenamiento y software orientada a mantener los chips haciendo trabajo útil.
Del prompt a la respuesta
- Entrada: la aplicación cifra y envía tu prompt.
- Enrutamiento: la plataforma autentica la solicitud y selecciona un clúster.
- Preparación: el texto se convierte en tokens; la aplicación puede recuperar documentos mediante RAG.
- Inferencia: una o varias GPU cargan el modelo y calculan los tokens de salida.
- Controles: se aplican políticas, filtros, registro y formato.
- Respuesta: el resultado regresa, a menudo de manera progresiva.
Entrenamiento, ajuste fino e inferencia
| Proceso | Función | Necesidad principal |
|---|---|---|
| Entrenamiento | Aprende parámetros con grandes conjuntos de datos | Muchas GPU coordinadas durante trabajos largos |
| Ajuste fino | Adapta un modelo existente | Datos especializados y menor escala relativa |
| Inferencia | Usa el modelo para responder | Baja latencia, disponibilidad y costo controlado |
La guía de Google Cloud distingue estas cargas porque no existe una configuración universal: un clúster óptimo para entrenar puede ser ineficiente para responder consultas en tiempo real.
Energía, refrigeración y seguridad
- Distribución eléctrica: transforma y reparte energía a cada rack.
- UPS: cubre el intervalo entre una falla de red y el respaldo.
- Generadores: sostienen cargas críticas durante cortes prolongados, según el diseño.
- Refrigeración: retira calor mediante aire, agua, líquido directo o combinaciones.
- Seguridad y telemetría: controlan accesos, incendios, temperatura, consumo y errores.
El Departamento de Energía de Estados Unidos explica cómo el calor puede pasar de los racks al aire, después a un circuito de agua y finalmente al exterior. También documenta refrigeración líquida directa, que transfiere calor desde el equipo a un circuito recirculado.
Redundancia y niveles Tier
Redundancia significa disponer de componentes o rutas alternas para energía, bombas, refrigeración y red. Uptime Institute clasifica instalaciones de Tier I a Tier IV. Tier III permite retirar de forma planeada una ruta o componente sin detener la operación; Tier IV añade tolerancia a una falla individual.
Una certificación de infraestructura no garantiza que una aplicación nunca falle. El software, los datos, la operación humana y la distribución entre regiones también determinan la disponibilidad.
Cómo se mide la capacidad
- kW por rack: potencia planificada para cada gabinete.
- MW del sitio: escala agregada; debe aclararse si corresponde a TI o a toda la instalación.
- GPU disponibles: cifra útil sólo junto con tipo, memoria, red y utilización.
- PUE: energía total del centro dividida entre la energía del equipo de TI.
Un PUE cercano a 1 implica menos consumo adicional en refrigeración y sistemas auxiliares, pero no mide productividad, agua, carbono ni utilización de GPU.
¿Qué ocurre cuando algo falla?
Ante un corte eléctrico, la UPS entra primero y el respaldo debe arrancar antes de agotar su autonomía. Si falla la refrigeración, los equipos reducen potencia o se apagan para protegerse. Si cae un enlace, el tráfico puede cambiar de ruta; sin capacidad alterna aparecen errores y latencia.
En entrenamiento, perder un nodo puede exigir reanudar desde un punto guardado. En inferencia, un balanceador puede enviar solicitudes a otra réplica. Estas respuestas dependen de diseño, pruebas periódicas y procedimientos operativos.
Infraestructura propia, colocation o nube
La infraestructura propia da control, pero exige capital, personal y energía disponible. Colocation permite conservar los equipos y delegar el edificio. La nube ofrece recursos medidos bajo demanda y elasticidad, características recogidas en la definición del NIST.
La decisión depende de utilización, soberanía de datos, latencia, plazo y dependencia del proveedor. Muchas organizaciones combinan nube para experimentar, capacidad reservada para producción y equipos propios para cargas estables o sensibles.
La idea clave
Un centro de datos de IA es una fábrica digital: recibe energía y datos, coordina cómputo, devuelve resultados y expulsa calor. Su capacidad real no corresponde solamente al número de GPU, sino al componente más limitado entre electricidad, refrigeración, red, almacenamiento y software.
Al evaluar un proveedor, pregunta por potencia, densidad por rack, red, estrategia térmica, redundancia comprobada, ubicación de datos y costo por carga útil. Esas respuestas revelan más que una cifra aislada de aceleradores.
Fuentes consultadas
- Google Cloud: AI Hypercomputer overview.
- Google Cloud: GPU networking overview.
- Google Cloud: deployment strategy.
- NVIDIA: DGX H100/H200 User Guide.
- U.S. Department of Energy: cooling and efficiency.
- Uptime Institute: Tier Certification.
- NIST SP 800-145.
Descubre más de Anivia Mx
Suscríbete para recibir las últimas entradas en tu correo electrónico.